Wenn Unternehmen zum ersten Mal über Formulardigitalisierung nachdenken, stellen sie sich oft eine einfache Lösung vor: Software scannt das Dokument, liest die Felder, fertig. Was in der Theorie plausibel klingt, scheitert in der Praxis an einem einzigen Problem – menschlicher Handschrift.
Das Problem mit reiner OCR-Software
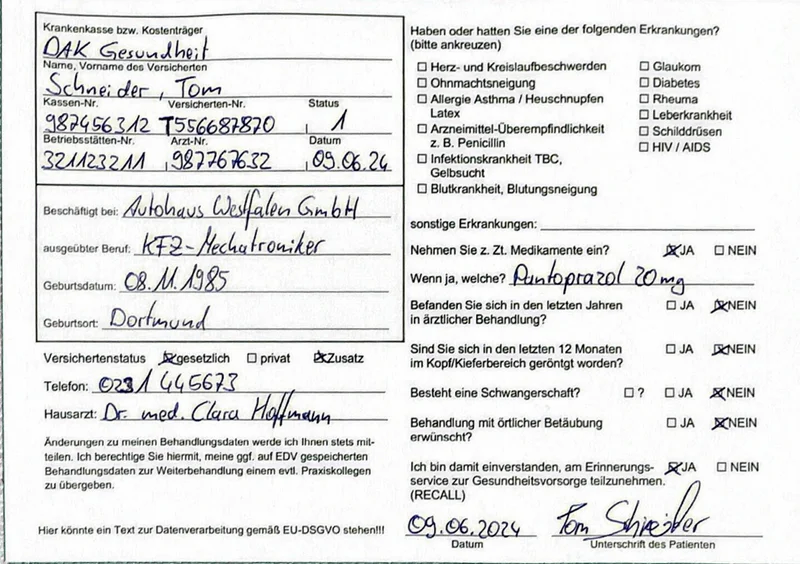
Standard-OCR-Tools wie Tesseract, ABBYY oder Adobe Acrobat sind für gedruckten Text optimiert. Bei handschriftlichen Formularen stoßen sie schnell an ihre Grenzen: Eine Fünf, die wie eine Sechs aussieht. Ein durchgestrichenes Feld mit Korrektur daneben. Tinte, die auf der Rückseite durchscheint. Für diese Fälle hat klassische OCR keine robuste Antwort.
Typische Fehlerrate reiner OCR bei handschriftlichen Unternehmensformularen: 10–20 %. Das klingt klein – ist aber bei 50.000 Formularen gleichbedeutend mit bis zu einer Million falsch erfasster Felder.
Warum 95 % nicht gut genug sind
Die Fehlerrate ist keine abstrakte Statistik. Ein Formular mit 50 Feldern und 95 % Genauigkeit enthält im Schnitt 2–3 falsche Einträge. Hochgerechnet auf 10.000 Formulare sind das 200.000–300.000 fehlerhafte Datenpunkte, die sich in Datenbanken, CRM- oder ERP-Systeme einschleichen. Dort sind sie schwer zu finden – und noch schwerer zu korrigieren, ohne die Herkunft zurückverfolgen zu können.
Bei sensiblen Dokumenten – Versicherungsanträgen, Patientenfragebögen, rechtlichen Erklärungen – kann ein einziger Fehler im falschen Feld ernsthafte Folgen haben.
Der hybride Ansatz: KI + Mensch
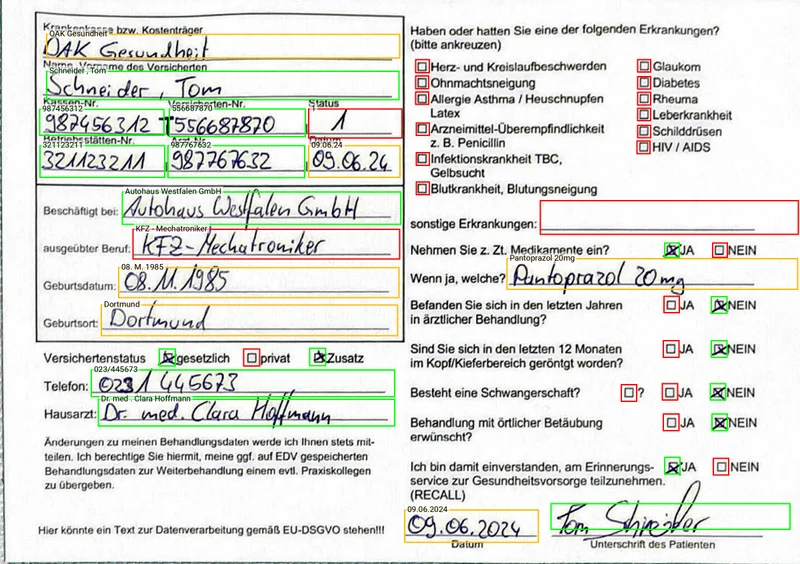
formalogix arbeitet in zwei Stufen. Zuerst analysiert eine trainierte KI jedes Feld und bewertet gleichzeitig ihre eigene Konfidenz: Wie sicher ist sie, dass sie das Richtige gelesen hat? Felder mit hoher Konfidenz werden direkt übernommen. Alles darunter – jedes unsichere Wort, jede mehrdeutige Zahl – landet im zweiten Schritt bei einem geschulten Menschen zur Prüfung.
- 1 KI-Ersterfassung mit Konfidenz-Score pro Feld
- 2 Automatische Markierung aller unsicheren Felder
- 3 Menschliche Verifikation der markierten Felder durch unser Team
- 4 Qualitätskontrolle der Gesamtausgabe vor Auslieferung
Das Ergebnis, gemessen an 1.000 Formularen: 99,8 % Feldgenauigkeit nach Verifikation – so genau wie manuelle Erfassung, meist genauer. Keine vertragliche Zusicherung, sondern eine Messung, die Sie an der ausgelieferten Datei nachrechnen können.
Genauigkeit nach Dokumenttyp
Nicht alle Dokumente sind gleich schwierig zu verarbeiten. Die folgende Tabelle zeigt, wie Standard-OCR und formalogix bei verschiedenen Dokumenttypen abschneiden:
| Dokumenttyp | Standard-OCR | formalogix |
|---|---|---|
| Maschinentext, strukturiert | 95–99 % | 99,9 % |
| Maschinentext, gescannt (alt) | 85–95 % | 99,5 % |
| Handschrift, klar | 70–85 % | 99,8 % |
| Handschrift, schwer leserlich | 40–60 % | 99,5 % |
| Gemischt (Druck + Handschrift) | 75–88 % | 99,8 % |
Erkennungsrate bei handschriftlichen Formularen
Der vollständige Verarbeitungsprozess
Was passiert genau, nachdem ein Formular bei uns eingeht? Die folgende Übersicht zeigt den vollständigen Ablauf von der Einlieferung bis zur strukturierten Ausgabedatei:
Eingang & Vorverarbeitung
Dokumente werden gescannt oder digital empfangen. Die Bildverarbeitung korrigiert Ausrichtung, Kontrast und Verzerrungen automatisch.
KI-Ersterfassung
Das Modell extrahiert alle Felder und vergibt einen Konfidenz-Score von 0–100 % pro Feld. Felder über dem Schwellenwert werden direkt übernommen.
Markierung & Verifikation
Alle Felder unter dem Schwellenwert werden automatisch markiert und unserem Verifikationsteam zugewiesen. Die Prüfung erfolgt ohne Zugang zu unnötigen Daten (Datensparsamkeit).
Qualitätskontrolle & Auslieferung
Ein abschließender Qualitätscheck prüft Vollständigkeit und Konsistenz. Die strukturierten Daten werden im gewünschten Format ausgeliefert (CSV, JSON, XML, API).
Wie der Konfidenz-Score funktioniert
Der Konfidenz-Score ist das Herzstück unseres Systems. Pro Feld berechnet die KI einen Wert zwischen 0 und 100 %, der ausdrückt, wie sicher sie ihre eigene Lesart einschätzt. Der Schwellenwert – ab dem ein Feld automatisch übernommen wird – ist nicht universell festgesetzt, sondern wird für jeden Kunden und jedes Formulartyp kalibriert. Für ein Feld mit Ganzzahlen (z. B. Postleitzahlen) liegt die Toleranzgrenze anders als für Freitext-Namensfelder.
Warum der Schwellenwert wichtig ist: Ein zu hoher Schwellenwert würde zwar mehr Felder zur menschlichen Prüfung schicken – und damit den Prozess verlangsamen und verteuern. Ein zu niedriger Schwellenwert akzeptiert unsichere Felder automatisch und senkt die Genauigkeit. Wir optimieren diesen Wert kontinuierlich auf Basis von Feedback aus der Qualitätskontrolle.
Was das in einem echten Projekt bedeutet
Bei einem Großprojekt für eine österreichische Gebäudeversicherung haben wir 103.000 handschriftliche Versicherungsanträge verarbeitet. Die KI hat rund 80 % aller Felder direkt und sicher erfasst. Die restlichen 20 % – korrigierte Einträge, unleserliche Schriften, überschriebene Felder – wurden von unserem Verifikationsteam überprüft. Vier Wochen später hatte der Kunde eine saubere, strukturierte Datenbasis.
Wann ist reine KI ausreichend?
Bei maschinell gedruckten, strikt strukturierten Formularen mit klar abgegrenzten Feldern kann reine OCR funktionieren – z. B. standardisierte Steuerformulare oder Zollpapiere. Sobald jedoch Handschrift, variable Layouts oder ältere Dokumente im Spiel sind, ist der hybride Ansatz die einzig verlässliche Option für produktionskritische Daten.
Nächster Schritt
Konkrete Formulare zu digitalisieren?
Senden Sie uns ein Beispiel – wir erstellen innerhalb von 24 Stunden ein Angebot.